Un puntaje compuesto único comprime docenas de señales en un solo número. Esa compresión es exactamente lo que destruye la confianza, porque el CSM no puede rastrear el número hasta una razón.
LABORATORIO DE IA · PROYECTO 01
La IA interpreta la evidencia y comunica resultados. No es dueña de la autoridad diagnóstica.
Un sistema de diagnóstico asistido por IA que evalúa si un cliente está logrando los resultados que justificaron la compra, identifica las condiciones que respaldan o amenazan esos resultados, expone evidencia faltante o contradictoria, y ayuda a los equipos de Customer Success a decidir qué merece atención primero.
Todo equipo de Customer Success termina construyendo, comprando o heredando un health score. Casi ninguno confía en él.
El patrón se repite en todas las empresas. Un modelo produce un número, normalmente rojo, amarillo o verde, y el CSM dueño de la cuenta no puede explicar por qué se movió. El número no puede decir qué evidencia usó, si esa evidencia alguna vez fue confirmada como cierta, o qué tendría que pasar para cambiarlo. Cuando el número y el juicio del propio CSM no coinciden, el número pierde, en silencio, y el equipo vuelve a las hojas de cálculo y a la intuición.
Eso no es una falla de herramienta. Es una falla de autoridad. Al sistema se le pidió tomar una decisión que no tenía forma de justificar.
La pregunta que este proyecto buscó responder: ¿puede un sistema asistido por IA evaluar la salud de un cliente de una forma en que un CSM o un ejecutivo realmente confíe, es decir, que muestre su evidencia, admita lo que no sabe, y nunca anule en silencio el criterio de una persona sobre la cuenta?
Antes de escribir una sola línea de metodología, la pregunta de partida fue por qué los health scores existentes no logran ganarse la confianza, no cómo construir una mejor fórmula de puntuación. Tres patrones de falla se repitieron en los enfoques revisados.
Un puntaje compuesto único comprime docenas de señales en un solo número. Esa compresión es exactamente lo que destruye la confianza, porque el CSM no puede rastrear el número hasta una razón.
La mayoría de los modelos de puntuación tratan cada dato de entrada como igualmente cierto. Un rumor de un hilo de correo y una renovación de contrato confirmada se promedian como si tuvieran el mismo peso.
Cuando falta evidencia o es contradictoria, la mayoría de los sistemas igual producen un número limpio en lugar de admitir el vacío. El resultado se ve decisivo hasta que resulta estar equivocado.
Un diagnóstico de salud se gana la confianza siendo auditable, no siendo inteligente.
La decisión de diseño central se derivó directamente de esa hipótesis: separar las partes del sistema que interpretan el lenguaje de la parte que decide el resultado.
Los modelos de lenguaje son genuinamente buenos leyendo evidencia desordenada del cliente, correos, notas de llamadas, tickets, y extrayendo señal estructurada de ahí. No son algo a lo que se le quiera dar autoridad única sobre una conclusión de negocio gobernada, porque pueden ser convincentes y estar equivocados al mismo tiempo.
Por eso el sistema se dividió en dos categorías de trabajo que nunca se mezclan: el trabajo de interpretación, que sigue siendo asistido por IA, y el trabajo de autoridad, que permanece basado en reglas y determinista. Un paso de confirmación humana se ubica entre ambos, deliberadamente. Nada de lo que la IA extrae de la evidencia puede afectar el resultado gobernado hasta que una persona lo confirme.
El método de 5 pasos
La evidencia atraviesa cinco etapas, y solo una de ellas tiene permitido decidir algo.
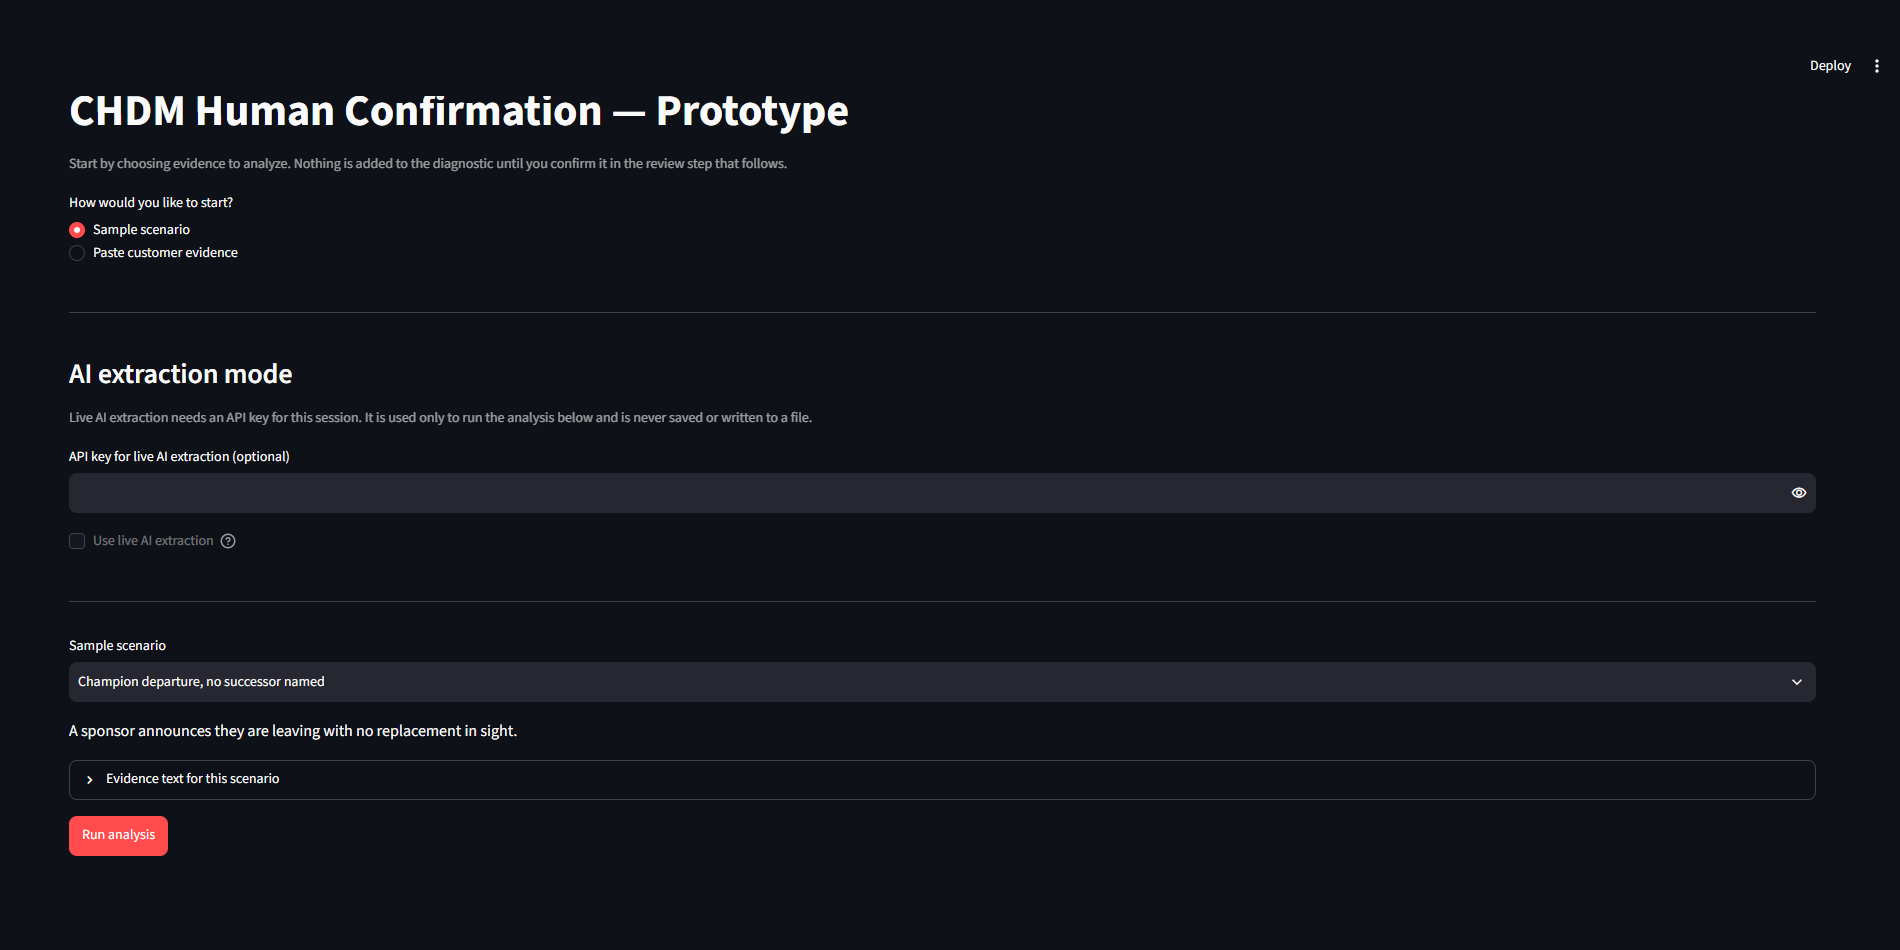
Notas, correos, resúmenes de llamadas: lo que un CSM ya tiene sobre la cuenta.
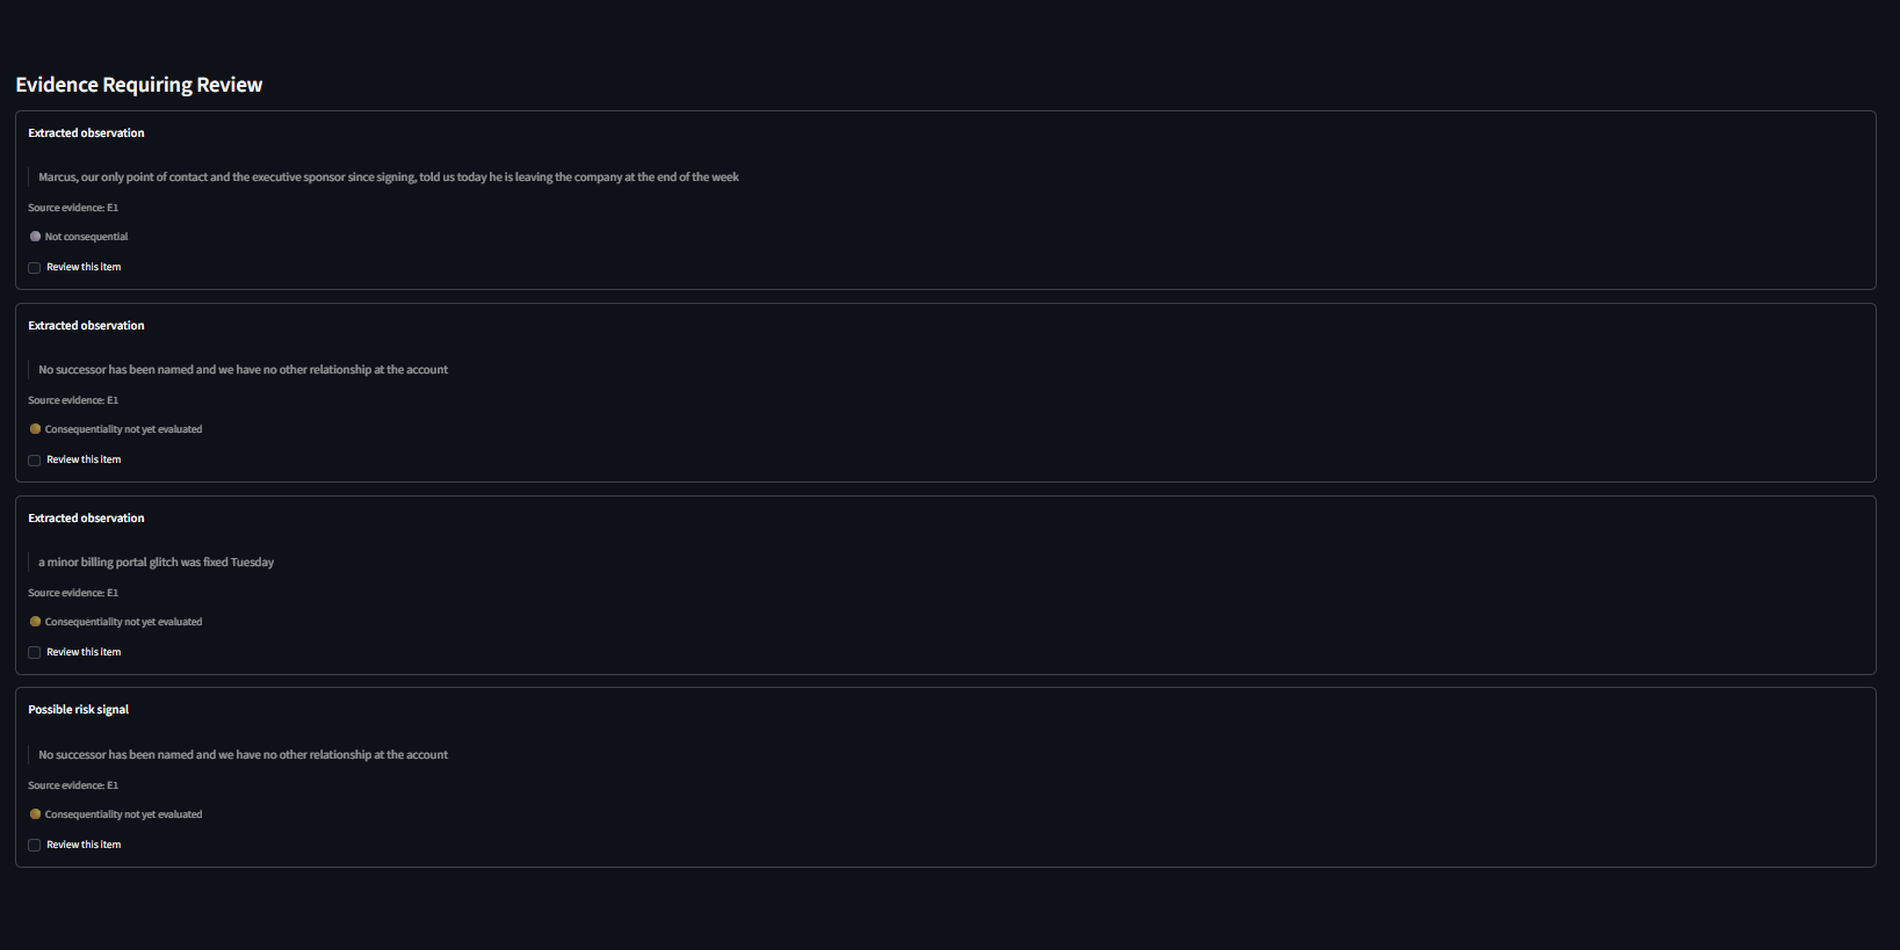
La evidencia se convierte en candidatos estructurados, como cambios de stakeholders, incidentes de servicio y señales de riesgo, cada uno rastreable hasta el texto exacto de origen del que provino.
Un revisor confirma, corrige o rechaza cada candidato antes de que pueda afectar algo más adelante. Nada consecuente avanza solo porque la IA lo dijo.
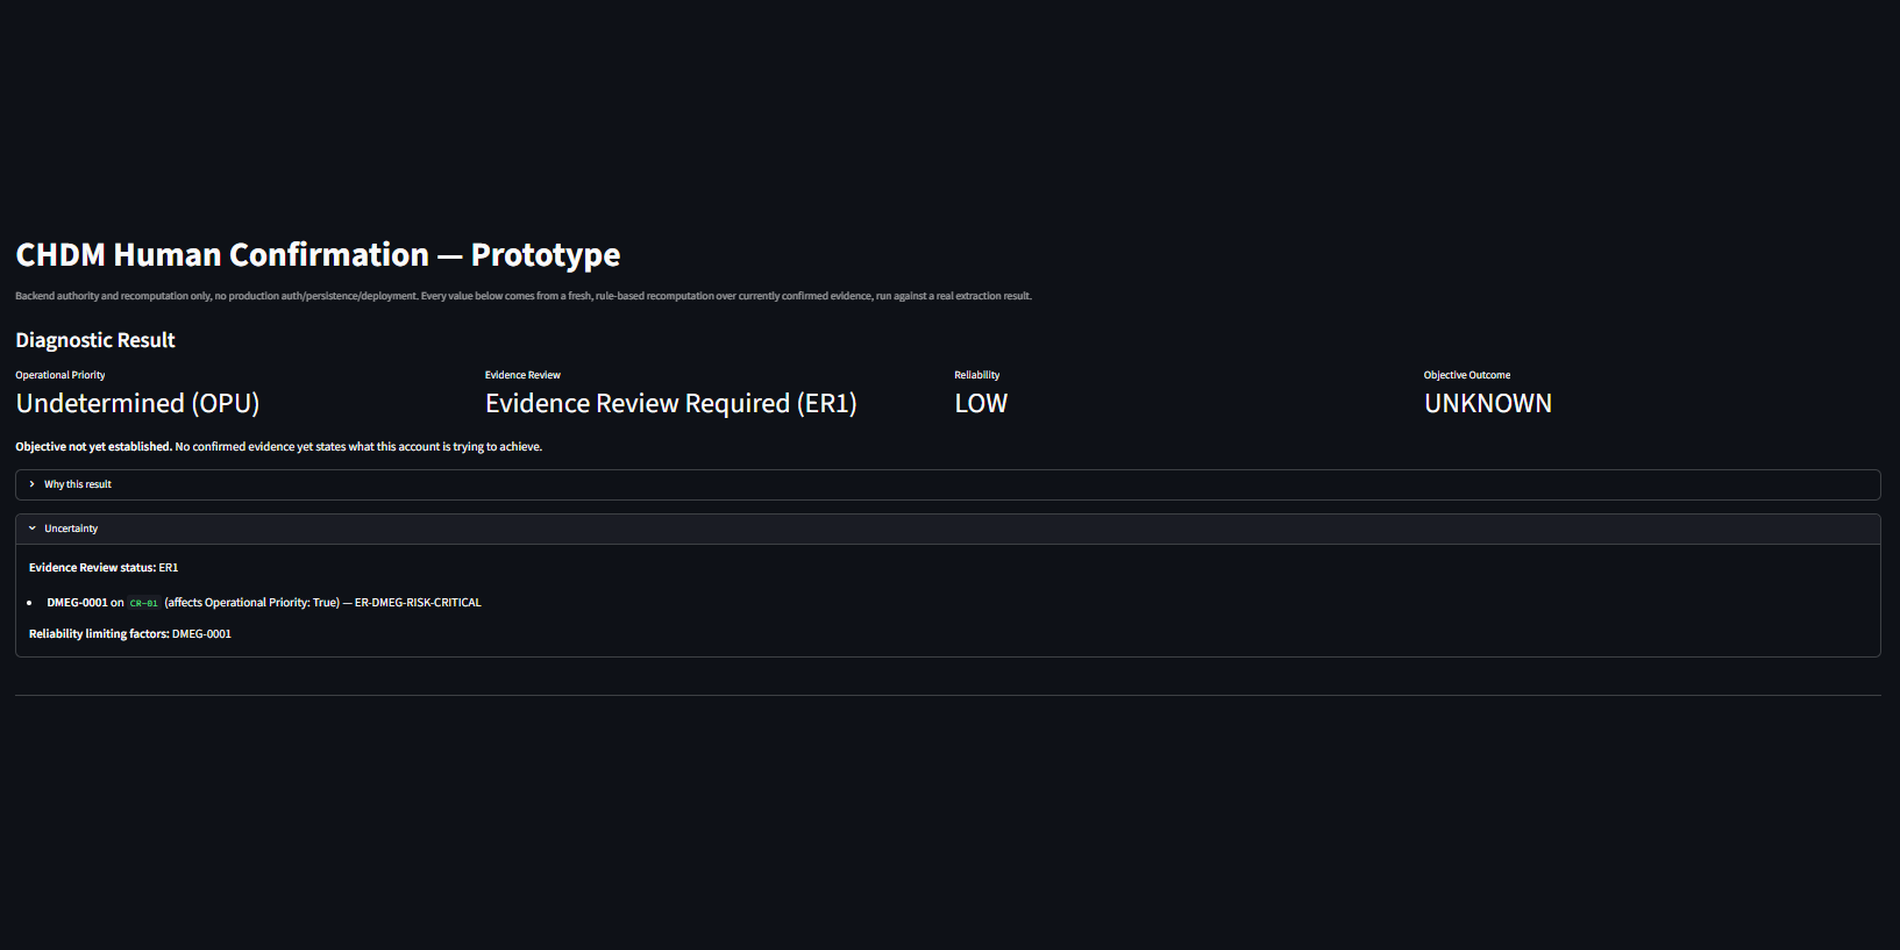
Una metodología fija y publicada, no un modelo ni un prompt, evalúa la evidencia confirmada y produce el resultado diagnóstico: resultado del objetivo, exposición al riesgo, prioridad operativa, y un recuento explícito de lo que permanece incierto.
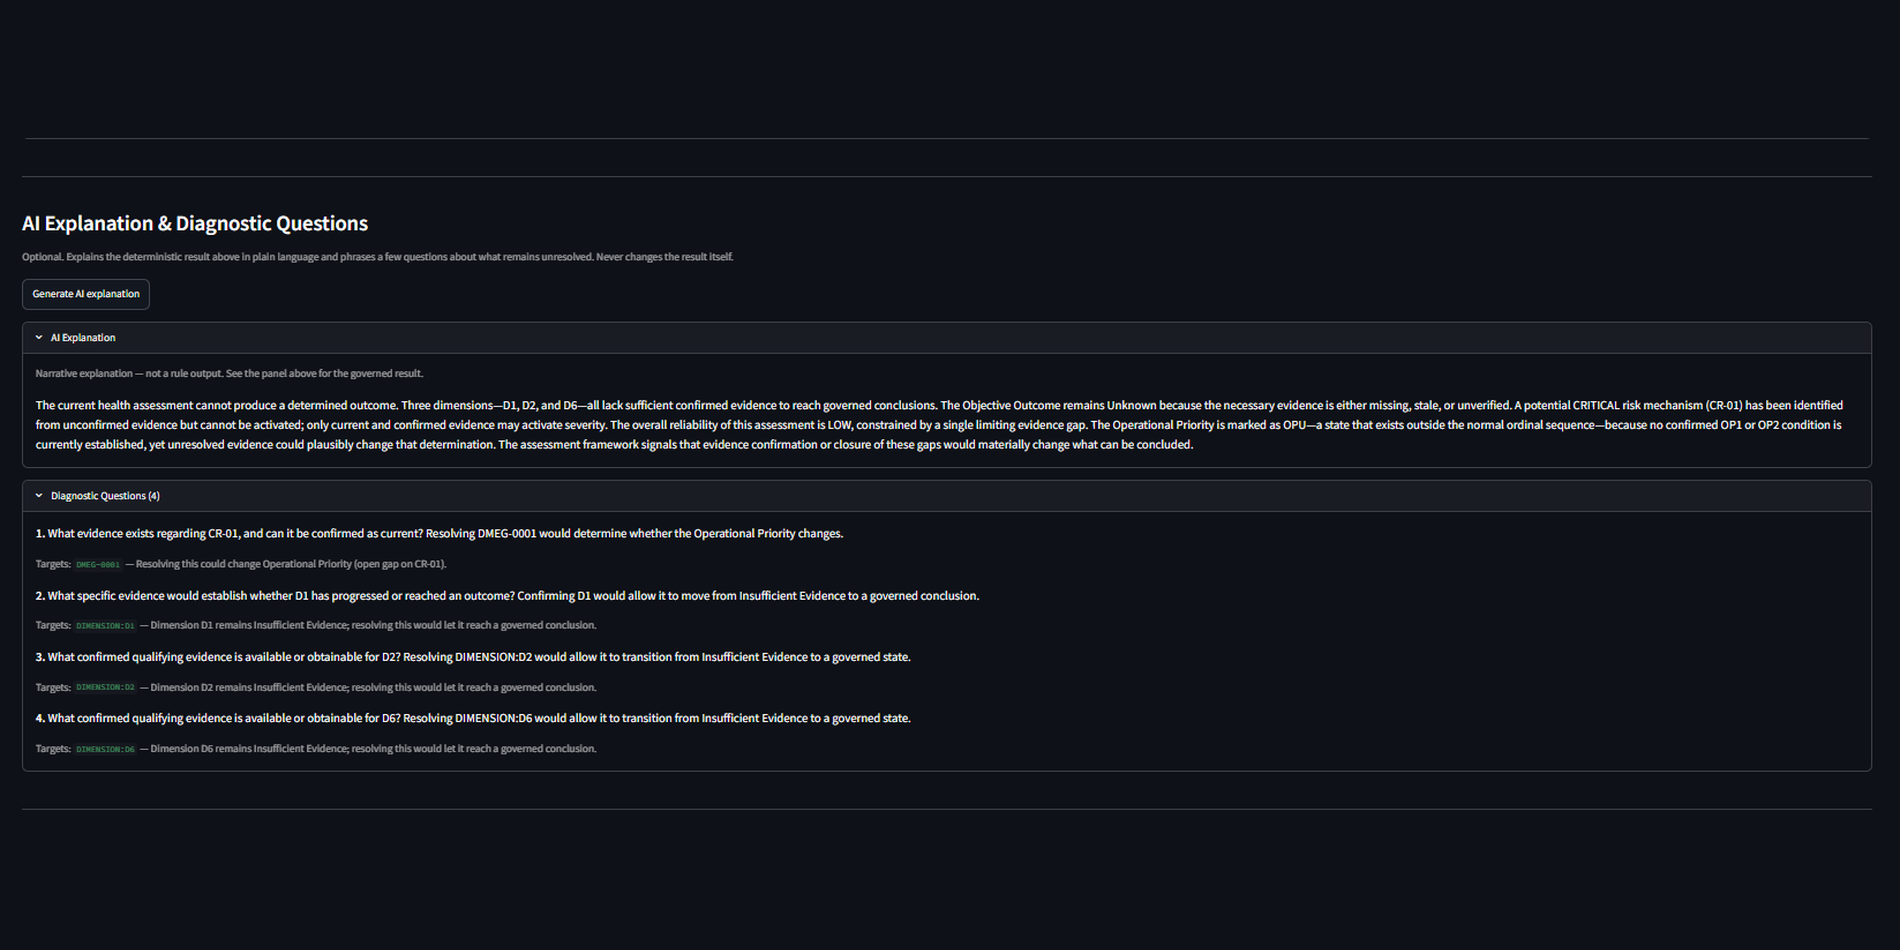
La IA vuelve a intervenir, solo para explicar el resultado gobernado en lenguaje sencillo y formular algunas preguntas sobre lo que sigue sin resolver. No puede introducir un hecho, un riesgo o una conclusión que no esté ya en el resultado gobernado.
La IA interpreta la evidencia y comunica resultados. No es dueña de la autoridad diagnóstica.
Ese límite se aplica en dos puntos separados, no solo se afirma en una diapositiva. En la extracción, todo candidato propuesto por la IA queda inerte hasta que una persona lo confirma; el motor de reglas solo lee evidencia confirmada. En la explicación, la IA recibe un paquete cerrado de hechos ya gobernados y referencias a vacíos sin resolver, nada más, y su respuesta se verifica contra ese paquete antes de que llegue a la pantalla. Si la explicación menciona algo fuera de ese paquete, no se muestra; el resultado diagnóstico subyacente se despliega solo, por su cuenta.
La IA puede equivocarse en cómo formula algo, y en el peor de los casos aparece un aviso simple de que la explicación no está disponible. No puede equivocarse en el diagnóstico en sí, porque nunca tiene voto sobre el diagnóstico.
Existe un prototipo funcional: una aplicación en Streamlit que guía a un revisor a través de todo el flujo, de principio a fin, desde la evidencia en bruto hasta un resultado gobernado y una explicación de IA. Las capturas de pantalla abajo son de esa aplicación en ejecución. Pruébala tú mismo con el escenario insignia, o revisa el código directamente.
El sistema se validó por capas, avanzando de lo sintético a lo real en cada etapa.
Un sistema construido sobre "admite lo que no sabes" debería exigirse el mismo estándar a sí mismo.
El reto técnico de este proyecto resultó ser la parte fácil. Lograr que un modelo de lenguaje extraiga señal estructurada de texto desordenado, o que formule una explicación coherente, es hoy un problema resuelto en la mayoría de los dominios que importan.
El problema más difícil, y el que vale la pena llevar a cualquier futuro sistema de IA, fue decidir dónde debía detenerse la voz de la IA y dónde debía empezar una regla, o una persona. Es tentador dejar que un modelo capaz maneje todo el juicio de principio a fin, porque puede hacerlo. La disciplina está en negarse a ese atajo deliberadamente: escribir de antemano, con precisión, qué decisiones la IA nunca puede tomar por su cuenta, y luego construir el software para que ese límite no se erosione en silencio a medida que el sistema crece.
Eso, en realidad, no es una lección de IA. Es una lección de operaciones disfrazada de IA: la autoridad tiene que diseñarse, no asumirse, o termina yéndose hacia la parte del sistema que resulta más convincente y no hacia la que resulta más responsable.
Donde la metodología operativa se pone a prueba contra una máquina, un proyecto a la vez.
VOLVER AL LABORATORIO DE IA CAPACIDAD 03La metodología sobre la que se construye este diagnóstico: el Customer Success Cycle y cómo realmente se gana la retención.
LEE EL MÉTODOLa autoridad tiene que diseñarse, no asumirse.
HABLEMOS DE LO QUE ESTO PODRÍA SIGNIFICAR PARA TU EQUIPO